Concept2017
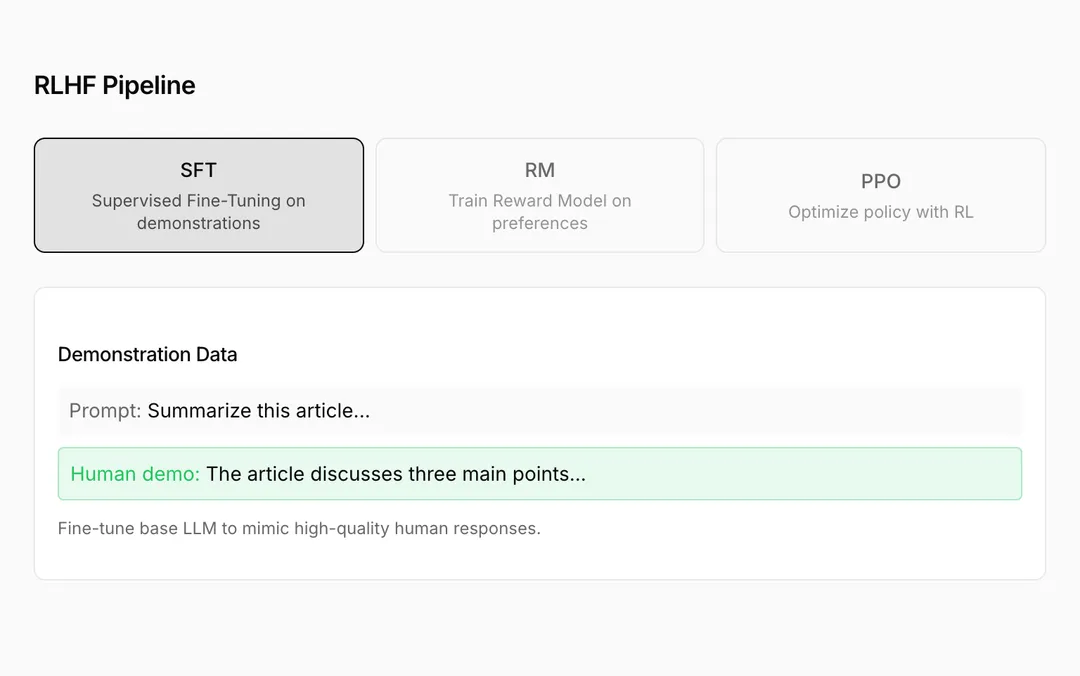
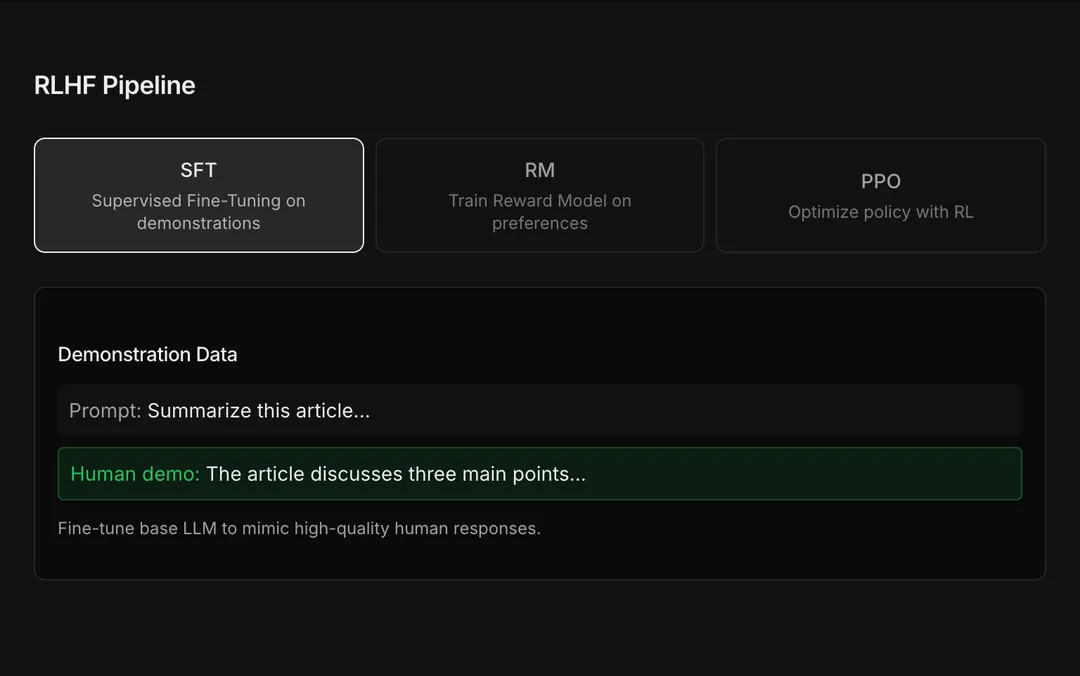
RLHF: Reinforcement Learning from Human Feedback
Christiano et al.
Teaching language models to prefer responses that people rank higher
1 entry / Filter in the index →
Concept2017
Christiano et al.
Teaching language models to prefer responses that people rank higher